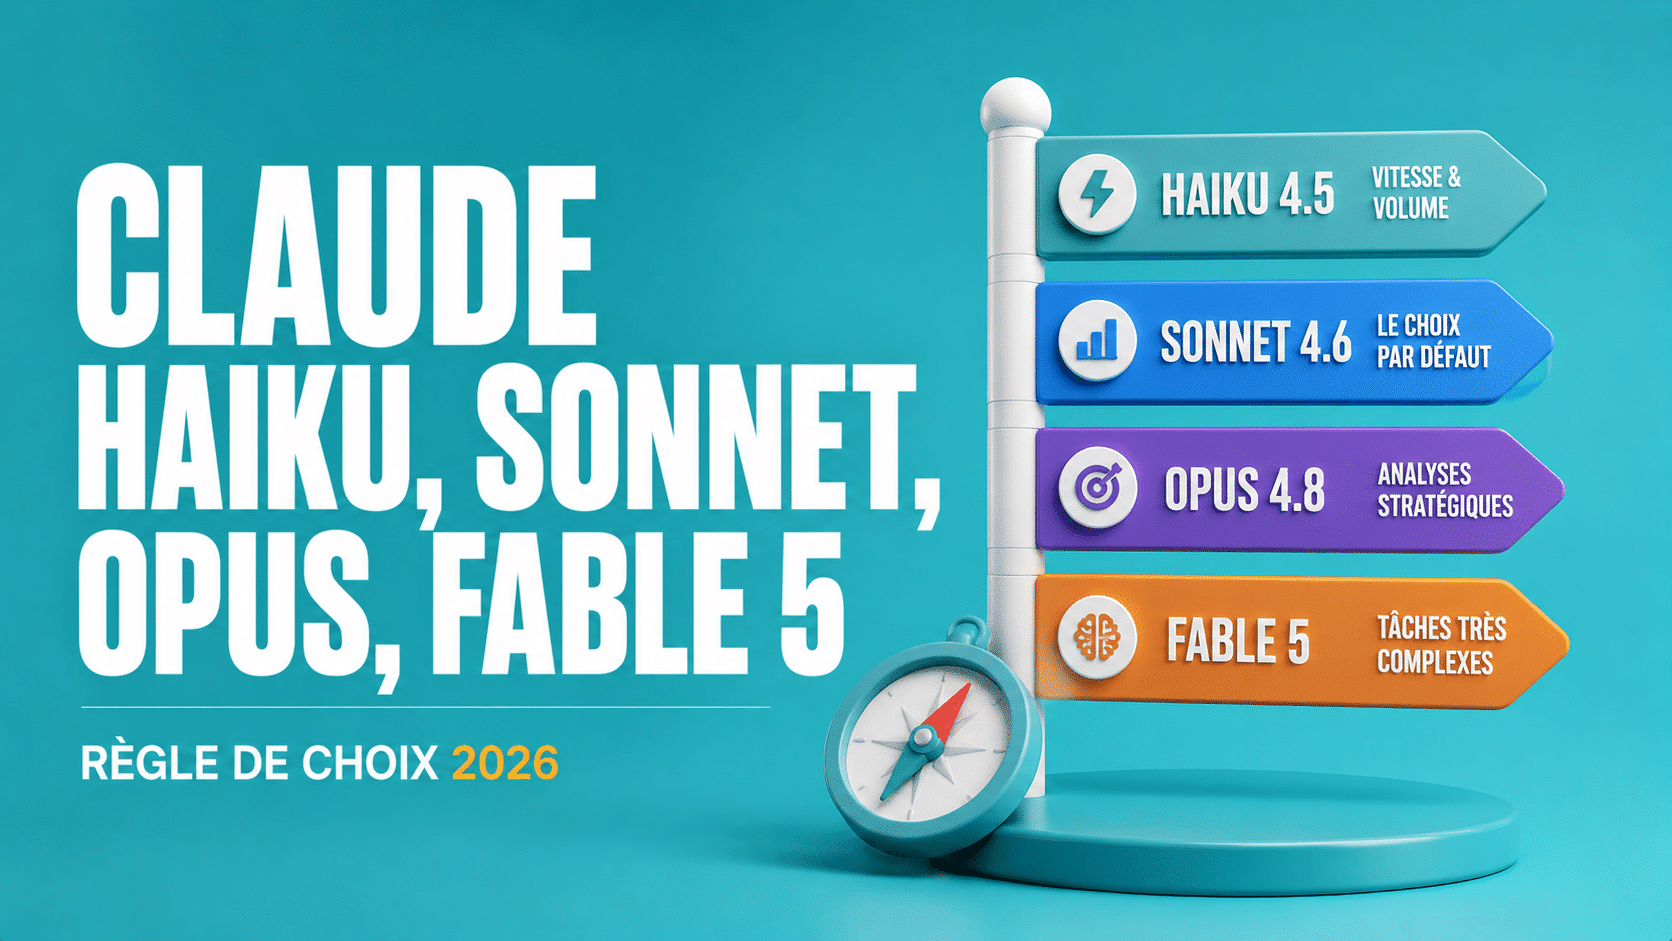
L’essentiel : Anthropic propose plusieurs modèles Claude en 2026, et la génération 5 a changé la donne. Claude Sonnet 5, sorti fin juin 2026, est devenu le modèle par défaut : il approche la puissance de l’ancien Opus 4.8 pour un tarif bien inférieur, autour de 2$ en entrée et 10$ en sortie par million de tokens. Claude Opus 5 est le modèle premium, réservé aux raisonnements les plus complexes, autour de 5$ et 25$. Claude Haiku 4.5 reste le plus rapide et le moins cher pour les tâches simples à gros volume, autour de 1$ et 5$. La grande nouveauté de 2026 ne concerne pas que les modèles : on règle désormais le niveau d’effort de raisonnement (de low à x-high), qui ajuste la profondeur d’analyse du modèle et donc son coût. Choisir Claude en 2026, c’est donc répondre à deux questions, pas une : quel modèle, et à quel effort. La règle simple, celle que j’applique pour mes clients : Sonnet 5 par défaut, Opus 5 quand la complexité le justifie, Haiku pour le volume, et l’effort calé sur l’enjeu réel de la tâche. Voici la grille complète, avec un piège de facturation que peu de gens connaissent.
Claude Sonnet vs Opus : la question a changé en 2026
Claude Sonnet vs Opus, ou faut-il plutôt Haiku ? C’est une des questions qu’on me pose le plus souvent quand j’accompagne une PME qui se met à Claude. Sauf qu’en 2026, la question elle-même a évolué, et c’est ce que la plupart des guides n’ont pas encore intégré.
J’utilise Claude tous les jours depuis 2024, sur des projets clients e-commerce, SEO et automatisation. Si vous débutez tout juste, je vous conseille d’abord mon guide pour bien utiliser Claude AI, puis de revenir ici pour choisir votre modèle. Et si votre hésitation porte sur l’outil plutôt que sur le moteur, mon comparatif de Claude Chat, Code, Cowork et Design traite exactement cette question-là. Et depuis l’arrivée de la génération 5, à l’été 2026, deux choses ont bougé. D’abord les modèles : Sonnet 5 et Opus 5 ont pris la relève de Sonnet 4.6 et Opus 4.8. Ensuite, et c’est le vrai changement, un nouveau réglage est apparu : l’effort de raisonnement. On ne choisit plus seulement un modèle, on choisit aussi combien il doit “réfléchir”.
Résultat : le mauvais choix coûte toujours autant, mais il y a maintenant deux leviers à mal régler au lieu d’un. J’ai vu des gens lancer Opus au maximum d’effort pour reformuler un e-mail, et brûler leur budget sur une tâche qu’un Sonnet en effort minimal aurait expédiée. Le bon réflexe n’a jamais été aussi important.
En 2026, choisir Claude ne se résume plus à “quel modèle”. La vraie question est devenue : quel modèle, et à quel effort.
Voici la grille exacte que j’applique, avec les modèles à jour, les tarifs, la notion d’effort, et un piège de facturation que peu connaissent.
Les modèles Claude en 2026 : la génération 5
La gamme Claude s’organise autour de trois modèles grand public de référence, désormais dominés par la génération 5.
Claude Sonnet 5 est le nouveau modèle par défaut, et sans doute le meilleur choix pour la plupart des usages professionnels. Sorti fin juin 2026 en remplacement de Sonnet 4.6, il offre une performance qui approche celle de l’ancien Opus 4.8, mais à un tarif bien plus bas, autour de 2$ en entrée et 10$ en sortie par million de tokens. C’est le modèle par défaut des plans Free et Pro. Pour de la rédaction, de l’analyse, du code, de la synthèse, il couvre la grande majorité des besoins d’une PME.
Claude Opus 5 est le modèle premium, pour les raisonnements les plus profonds et les analyses les plus complexes. Son tarif, autour de 5$ en entrée et 25$ en sortie par million de tokens, en fait un outil à réserver aux tâches qui le justifient vraiment : décisions multi-critères, problèmes de code ardus, analyses stratégiques. Notez qu’Opus 4.8, la version précédente, reste disponible et sélectionnable, et fait toujours un excellent travail : si vous l’utilisez déjà, rien ne vous oblige à basculer du jour au lendemain.
Claude Haiku 4.5 reste le sprinteur de la gamme : rapide, économique (autour de 1$ en entrée et 5$ en sortie par million de tokens), idéal pour les tâches simples et répétitives à fort volume comme la classification, l’extraction de données ou les résumés. Sur ces travaux, il fait aussi bien que les autres pour une fraction du prix.
Au-dessus de cette triade existe une gamme encore plus puissante (la famille Fable), destinée à des besoins très spécifiques et bien au-delà de ce qu’une PME utilise au quotidien. Pour l’immense majorité des usages professionnels, Sonnet 5, Opus 5 et Haiku 4.5 sont le terrain de jeu pertinent. Les tarifs et versions évoluant vite, vérifiez toujours la page officielle d’Anthropic pour les montants exacts au moment où vous lisez ces lignes.
Tableau comparatif des modèles Claude
Voici les trois modèles de référence côte à côte. Les tarifs sont par million de tokens (l’unité de facturation), en entrée puis en sortie.
| Critère | Haiku 4.5 | Sonnet 5 | Opus 5 |
|---|---|---|---|
| Profil | Rapide et léger | Équilibre, par défaut | Raisonnement profond |
| Tarif entrée | ~1$ / M tokens | ~2$ / M tokens | ~5$ / M tokens |
| Tarif sortie | ~5$ / M tokens | ~10$ / M tokens | ~25$ / M tokens |
| Usage idéal | Volume simple, extraction, résumés | Rédaction, analyse, code, quotidien | Analyses complexes, décisions difficiles |
| Réglage d’effort | Limité | Oui (low à x-high) | Oui (low à x-high) |
La lecture clé : Sonnet 5 offre le meilleur rapport puissance-prix du marché en approchant les performances de l’ancien Opus 4.8 pour environ un tiers du coût d’Opus 5. C’est ce qui en fait le choix par défaut évident pour la plupart des tâches.
La vraie nouveauté 2026 : le niveau d’effort
Voici le changement que personne n’explique encore clairement, et qui mérite qu’on s’y attarde. Depuis la génération 5, vous ne choisissez plus seulement un modèle, vous réglez aussi son niveau d’effort de raisonnement. C’est un curseur qui détermine combien le modèle va “réfléchir” avant de répondre.
Les niveaux vont généralement de low à x-high, en passant par medium, high et max. Plus l’effort est élevé, plus le modèle prend le temps de raisonner en profondeur, ce qui améliore la qualité sur les tâches complexes, mais consomme davantage de tokens et coûte donc plus cher. À l’inverse, un effort faible répond vite et à moindre coût, ce qui suffit largement pour les tâches simples.
Concrètement, cela ajoute une dimension à votre décision. Un même modèle peut être économique ou coûteux selon l’effort choisi. Régler Sonnet 5 en effort faible pour classer des messages, c’est parfait. Le pousser en effort élevé pour une analyse stratégique délicate, c’est justifié. Mais mettre l’effort au maximum pour une tâche triviale, c’est gaspiller, exactement comme choisir un modèle trop puissant.
Ma règle pratique : adaptez l’effort à l’enjeu réel de la tâche, pas par réflexe. Pour l’immense majorité des usages quotidiens, un effort moyen suffit. Réservez les efforts élevés aux moments où la profondeur de raisonnement change vraiment le résultat. Anthropic a d’ailleurs relevé ses limites d’usage pour accompagner la consommation accrue des efforts élevés, signe que ce réglage a un impact réel sur les tokens consommés.
Le niveau d’effort, c’est l’accélérateur d’une voiture : ce n’est pas parce qu’il monte à x-high qu’il faut rouler à fond tout le temps.
Le piège de facturation que peu connaissent
Un point technique qui a des conséquences très concrètes sur votre budget, et que je n’ai vu expliqué nulle part en français. La génération 5 utilise un nouveau tokenizer, c’est-à-dire une nouvelle façon de découper le texte en tokens (les unités facturées).
Conséquence : pour un même texte, Sonnet 5 génère environ 30% de tokens de plus que Sonnet 4.6. Autrement dit, le prix par token a baissé, mais le nombre de tokens facturés pour le même document a augmenté. Un traitement qui comptait 10 000 tokens sur l’ancien modèle en compte environ 13 000 sur le nouveau. Le tarif affiché plus bas ne se traduit donc pas mécaniquement par une facture plus basse.
Ce n’est pas une raison d’éviter Sonnet 5, qui reste un excellent rapport qualité-prix, mais c’est une raison de ne pas se fier au seul prix affiché. Si vous automatisez à grande échelle, testez sur vos propres contenus avant d’extrapoler un budget. C’est le genre de détail qui fait déraper une prévision de coûts, et le connaître vous évite une mauvaise surprise.
La règle de décision, tâche par tâche
Voici la règle concrète que j’applique, adaptée à la nouvelle donne modèle plus effort.
Sonnet 5, effort moyen, par défaut. Pour la rédaction, l’analyse courante, le code, la synthèse, les réponses clients : c’est votre configuration de base. Elle couvre l’immense majorité des besoins d’une PME avec une qualité largement suffisante, à un coût raisonnable.
Opus 5, effort élevé, pour la complexité réelle. Réservez cette combinaison aux tâches où Sonnet montre ses limites : analyse stratégique à plusieurs variables, raisonnement délicat, problème de code que Sonnet ne démêle pas. Testez toujours d’abord sur Sonnet : si le résultat suffit, vous venez d’économiser plusieurs fois le prix.
Haiku 4.5, effort faible, pour le volume. Dès que vous traitez beaucoup d’opérations simples (classer des centaines d’emails, extraire des données en masse, résumer), Haiku en effort réduit fait le travail pour une fraction du coût.
La logique en une phrase : partez de Sonnet 5 à effort moyen, montez en modèle ou en effort seulement quand la tâche le justifie vraiment, descendez dès qu’elle est simple. C’est cette discipline sur les deux leviers qui optimise votre budget sans sacrifier la qualité.
Vous voulez exploiter Claude au maximum dans votre activité ?
M-Twice forme les PME et indépendants belges à Claude, avec deux formations en présentiel à Braine-l’Alleud : les fondamentaux pour bien démarrer, et une formation dédiée au marketing digital (SEO, Meta Ads, contenu, lead generation).
FAQ, choisir entre les modèles Claude
Quelle est la différence entre Claude Sonnet et Opus ?
La différence entre Claude Sonnet et Opus tient à l’équilibre entre puissance de raisonnement et coût. En 2026, avec la génération 5, Claude Sonnet 5 est le modèle équilibré et par défaut : il approche les performances de l’ancien Opus 4.8 pour un tarif bien inférieur, autour de 2$ en entrée et 10$ en sortie par million de tokens, et couvre la grande majorité des usages professionnels (rédaction, analyse, code, synthèse). Claude Opus 5 est le modèle premium, conçu pour les raisonnements les plus profonds et les analyses les plus complexes (décisions multi-critères, problèmes difficiles, code ardu), à un tarif nettement supérieur, autour de 5$ en entrée et 25$ en sortie par million de tokens, soit environ le triple de Sonnet 5. En pratique, la règle recommandée est d’utiliser Sonnet 5 par défaut et de ne passer à Opus 5 que lorsque la tâche est réellement complexe et que Sonnet montre ses limites. Tester d’abord sur Sonnet permet souvent de constater que le résultat suffit, et donc d’économiser. Depuis la génération 5, s’ajoute un second levier : le niveau d’effort de raisonnement, réglable de low à x-high, qui ajuste la profondeur d’analyse et le coût indépendamment du modèle choisi. Choisir entre Sonnet et Opus ne suffit donc plus : il faut aussi caler l’effort sur l’enjeu réel de la tâche.
Qu’est-ce que le niveau d’effort dans Claude ?
Le niveau d’effort est un réglage introduit avec la génération 5 des modèles Claude, qui détermine la profondeur de raisonnement du modèle avant qu’il ne réponde. Les niveaux s’échelonnent généralement de low (effort faible) à x-high (effort très élevé), en passant par medium, high et max. Plus le niveau d’effort est élevé, plus le modèle prend le temps de raisonner en profondeur, ce qui améliore la qualité des réponses sur les tâches complexes, mais consomme davantage de tokens et augmente donc le coût. À l’inverse, un niveau d’effort faible produit une réponse plus rapide et moins coûteuse, ce qui convient parfaitement aux tâches simples. Cette notion ajoute une dimension importante au choix d’un modèle Claude : un même modèle peut se révéler économique ou coûteux selon l’effort sélectionné. Concrètement, il est recommandé d’adapter l’effort à l’enjeu réel de la tâche plutôt que de le pousser au maximum par réflexe. Un effort moyen suffit pour l’immense majorité des usages quotidiens, tandis que les efforts élevés se réservent aux analyses où la profondeur de raisonnement change véritablement le résultat. Anthropic a relevé ses limites d’usage pour accompagner la consommation accrue des niveaux d’effort élevés, ce qui confirme leur impact réel sur les tokens consommés et donc sur le budget.
Quel modèle Claude choisir pour une PME en 2026 ?
Pour une PME en 2026, le modèle Claude à privilégier par défaut est Claude Sonnet 5, devenu le modèle standard depuis son lancement fin juin 2026. Il offre le meilleur rapport entre puissance, vitesse et coût, en approchant les performances de l’ancien Opus 4.8 pour un tarif bien inférieur (environ 2$ en entrée et 10$ en sortie par million de tokens), et couvre la grande majorité des besoins professionnels : rédaction de contenu, analyse, réponses clients, code, synthèse de documents. Pour les traitements simples à fort volume (classer de nombreux emails, extraire des données, résumer en masse), Claude Haiku 4.5 est plus indiqué, car il fait le travail aussi bien pour une fraction du coût (environ 1$ et 5$ par million de tokens). Pour les tâches les plus complexes et à fort enjeu (analyse stratégique, raisonnement délicat, code ardu), Claude Opus 5 apporte une profondeur supérieure, à un coût plus élevé (environ 5$ et 25$), ce qui justifie de le réserver aux cas qui en ont réellement besoin. À ce choix de modèle s’ajoute le réglage du niveau d’effort : un effort moyen pour l’usage quotidien, faible pour le volume simple, élevé pour la complexité réelle. La règle d’or reste d’adapter à la fois le modèle et l’effort à la tâche, pour éviter les deux erreurs coûteuses que sont l’usage d’un modèle ou d’un effort surdimensionné sur des tâches triviales, et l’inverse sur des analyses exigeantes.
Combien coûtent les modèles Claude en 2026 ?
En 2026, les tarifs de l’API Claude se comptent par million de tokens, séparément pour l’entrée (ce que vous envoyez) et la sortie (ce que le modèle génère). Claude Haiku 4.5 coûte environ 1$ en entrée et 5$ en sortie, ce qui en fait le modèle le plus économique pour les gros volumes de tâches simples. Claude Sonnet 5, le modèle par défaut, coûte environ 2$ en entrée et 10$ en sortie, un excellent rapport puissance-prix puisqu’il approche les performances de l’ancien Opus 4.8 pour bien moins cher. Claude Opus 5, le modèle premium, coûte environ 5$ en entrée et 25$ en sortie par million de tokens. Un point important à connaître : la génération 5 utilise un nouveau tokenizer qui produit environ 30% de tokens en plus pour un même texte par rapport à la génération précédente. Le prix par token a donc baissé, mais le nombre de tokens facturés pour un même document a augmenté, si bien que la facture réelle ne diminue pas proportionnellement au tarif affiché. Il est donc conseillé de tester sur ses propres contenus avant d’établir un budget. Par ailleurs, l’usage via l’interface de chat (abonnements Pro, Max, Team, Enterprise) fonctionne au forfait mensuel, différemment de l’API facturée au token. Les tarifs évoluant régulièrement, il est essentiel de vérifier la grille officielle d’Anthropic pour les montants exacts au moment de votre projet.